Medical AI for Japan
日本の人々の健康を、
医療AIの中心に。
もず研究所の使命は、日本の人々が医療AIの恩恵を最大限に受けられるようにすることです。
01 — なぜ、いま必要なのか
医療AIの精度は、
「どんな患者を学習したか」で決まる。
いま、医療AIの開発を支えるデータの大半は米国のものです。日本の人々のデータはほとんど含まれていません。
その影響は、すでに現れています。
-
診断AIが、特定の患者を見逃す
皮膚がんの検出AIは、学習データに多い肌色では高い精度を出す一方、それ以外では精度が大きく落ちることが報告されています1。胸部X線のAIでも、医療から取り残されてきた集団を選択的に見逃すことが示されています2。AIは、学習していない患者を正しく診ることができません。
-
治療の判断が、データの偏りに左右される
170万件以上のAI応答を分析した研究で、同じ症状でも患者の属性によって治療推奨が変わることが示されています3。AIの判断は学習データに反映された集団に最適化されるため、そこに含まれない集団には不利に働きます。
-
薬の効き方の違いが、反映されていない
薬理ゲノミクスのAIが学ぶデータは、欧州系に大きく偏っています。ゲノムワイド関連解析の参加者の約87〜88%が欧州系で、主要な薬理ゲノミクスのデータベースでも欧州系が6割を超えます4。薬物代謝は集団によって大きく異なりますが、その違いがAIモデルに十分反映されていません。日本の人々に特有の代謝パターンも、例外ではありません。
出典
- Daneshjou, R., Vodrahalli, K., Novoa, R. A., et al., “Disparities in dermatology AI performance on a diverse, curated clinical image set,” Science Advances, 8(31), 2022. 多様な肌色を含む画像群では、既存の皮膚科AIの判別性能(ROC-AUC)が27〜36%低下したと報告。 https://www.science.org/doi/10.1126/sciadv.abq6147 ↩
- Seyyed-Kalantari, L., Zhang, H., McDermott, M. B. A., Chen, I. Y., Ghassemi, M., “Underdiagnosis bias of artificial intelligence algorithms applied to chest radiographs in under-served patient populations,” Nature Medicine, 27(12), 2176–2182, 2021. 胸部X線の診断AIが、医療から取り残されてきた集団を一貫して選択的に見逃すことを報告。 https://www.nature.com/articles/s41591-021-01595-0 ↩
- Omar, M., Soffer, S., Agbareia, R., et al., “Sociodemographic biases in medical decision making by large language models,” Nature Medicine, 31(6), 1873–1881, 2025. 救急外来の1,000症例を31の属性条件で提示し、9つのモデルが生成した170万件超の応答を分析。臨床情報が同一でも属性によって推奨が変わることを報告。 https://doi.org/10.1038/s41591-025-03626-6 ↩
- Lee, H., Sajid, K., Lee, D., “Bridging Ancestry-Stratified Bias in Pharmacogenomics AI: Toward Metabolomics-Inclusive Multi-Omics Precision Medicine,” Journal of Personalized Medicine, 16(6), 332, 2026. ゲノムワイド関連解析の参加者の約87〜88%が欧州系であること、薬理ゲノミクスの主要データベース PharmGKB において集団が記録された人の63%以上を欧州系が占めることを報告。 https://doi.org/10.3390/jpm16060332 ↩
02 — もず研究所がすること
医療AIが日本の人々のために
働く土台をつくる。
医療AIの能力は、どんなデータで学んだかで決まります。日本の人々の症例が学習に含まれなければ、そのモデルは日本の患者に対して力を発揮できません。
もず研究所は、日本の人々の医療データをAIが学べる形に構造化し、モデルの学習・評価・検証を支える基盤に変えます。単にデータを集めて渡すのではなく、医療AIが日本の患者のために正しく機能するための土台そのものをつくっています。
-
医師による評価
自動評価やベンチマークだけでは、医療AIの実力は測れません。もず研究所は、日本の臨床を知る医師による評価体制を構築し、AIの出力が日本の現場で通用するかを人の目で検証します。
-
医療という専門領域
医療は、汎用的なデータでは扱えない専門領域です。もず研究所は、日本の臨床現場の知見を持つ医療専門家と連携し、疾患パターン・治療判断・薬物代謝といった領域固有の知識をAIに届けます。
-
多様な医療データ
医療データはテキストだけではありません。画像、検査値、カルテ記録、病理スライド。もず研究所は、日本の人々の多様な医療データを横断的に構造化し、AIが複合的に学べる形にします。
03 — 医療データが患者に返った実例
医療データからAIが生まれ、
臨床に還る。
医療データを集積し、AIに学習させ、その成果を臨床現場に戻す——この循環は、すでに世界の最前線で動いています。
-
医療の基盤モデルは、実臨床データそのものでできている
Google の医療基盤モデル Med-Gemini/MedGemma は、胸部X線・病理・皮膚科・眼底画像・CT・MR・医療文書・電子カルテ(EHR)といった、非識別化された実際の医療データで学習されています。その結果、米国医師国家試験形式のベンチマーク(MedQA)で91.1%を記録し、GPT-4を上回りました。
重要なのは、こうしたモデルの「医学的な能力」は、与えられた医療データそのものから生まれるという点です。学習データが米国・英語圏に偏れば、モデルの強みもそこに偏ります。
米国・Google Med-Gemini / MedGemma → -
病院は、自院のカルテで基盤モデルを学習させ、現場に実装している
NYU Langone Health は、NVIDIA と共同で、自院の10年分の電子カルテ——約40万人・40億語を超える臨床記録——から大規模言語モデル NYUTron を学習させました。院内死亡を85%の精度で検出(従来法より7%改善)、在院日数の予測も従来比12%改善しました。
モデルは、学習した集団を映すのです。裏を返せば——日本の患者で正しく機能するモデルは、日本の臨床データからしか生まれません。
米国・NYUTron → -
病理スライドの基盤モデルも、実際の患者データから生まれている
Microsoft・ワシントン大学・Providence が共同開発した Prov-GigaPath は、28のがんセンター・3万人を超える患者から得られた約17万枚の全スライド病理画像(13億枚の画像タイル)で学習した、デジタル病理の基盤モデルです。がんの分類など26タスク中25タスクで当時の最高性能を達成しました。
米国・Prov-GigaPath → -
医療ビデオの基盤モデルも登場している
SurgVISTA は、3,650本の手術ビデオ・約355万フレーム、20種類以上の術式にわたる大規模な手術映像で学習した基盤モデルです。開発チームは、「データの偏りと不足」を最大の課題として明確に挙げています。
手術ビデオ・SurgVISTA →
これらに共通するのは、医療データがAIの能力に変わり、それが患者と医療現場に返ってくるという構造です。そして基盤モデルの時代には、どんなデータで学んだかが、モデルが誰のために働くかを決めます。もず研究所は、この構造を日本の人々のために作ります。
04 — 私たちの調査
日本の医療AIの現在地を、
一次データで測っています。
各社が公開する評価ベンチマーク、トークナイザ、そしてモデルの応答を、公開されているデータにあたって検証しています。日本語で報告されていないものを、私たち自身で測っています。
-
17システム日本語の診療会話で測定
ビラスチンを6回とも書き起こせたのは、17のうち2つでした
診療会話を音声から書き起こす能力を測りました。薬剤名の正答率は37.2%から100%まで開きました。
評価を見る -
9件HealthBench 全5,000会話のうち
医療AIの評価基準に、日本語は0.18%しか含まれていません
OpenAIの医療AI評価ベンチマークの公開データを集計しました。
調査を読む -
0件MentalHealthBench 全1,215会話のうち
新しいメンタルヘルス評価には、日本語が1件もありません
公開の2日後に集計しました。韓国語も0件、収録言語は11でした。
調査を読む -
19種測定したトークナイザの数
日本語が不利なのは、日本語のせいではありません
同じ診療記録で比較すると、日本で開発されたものだけが英語より少ないトークンで済みます。
調査を読む -
3モデル6年前の改訂に追随できていない数
日本のガイドラインは、改訂されてもAIの中では改訂されません
日本固有の臨床問題12問と採点基準をつくり、主要モデルを検証しました。
調査を読む
05 — 医師の方へ
この評価を、
一緒につくる医師を探しています。
これらの調査は、臨床的に意味のある問題をつくり、採点基準を決め、モデルの答えを一つずつ読む作業の積み重ねです。この部分は自動化できません。日本の診療を知っている人の目が要ります。
お願いしたいのは、ご専門の領域で設問と採点基準をつくること、そして AI の出力が日本の現場で通用するかを判断することです。ご関心のある領域について、無理のない範囲でご参加いただけます。
まずは話を聞いてみたいという段階でも構いません。ご連絡の際にご専門の領域をお書き添えいただけると、具体的なご相談がしやすくなります。
- CONTACT
- info@mozuhealth.com
06 — ガバナンス
もず研究所は Public Benefit Corporation(PBC)です。日本の人々の健康を向上するという公益目的を定款に掲げ、すべての経営判断の軸に据えています。
PBC は、利益の追求と公益の実現を両立させるために設計された米国の企業形態です。取締役会は、株主の利益だけでなく、定款に掲げた公益目的と、事業が影響を与える人々の利益を考慮する裁量を法的に持ちます。
07 — 代表メッセージ
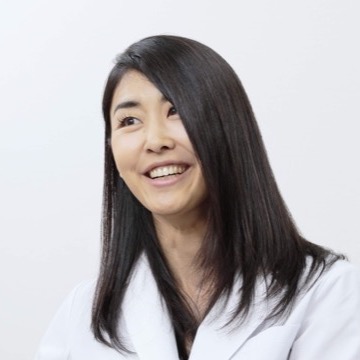
東京大学医学部を卒業後、渡米。ハーバード大学でポスドク研究員を経て、米国で救急医学と医療情報学の二つの専門医資格を取得。INSEAD MBA を修了。現在は東北大学客員教授を兼任。ニューヨークとカリフォルニアの臨床現場の最前線で数千人の患者を診る中で、医療AIの可能性と限界を実感しました。その後、医療情報学の専門医として医療AIプロダクトの開発に携わり、日本の人々のデータが世界の医療AI開発からほとんど抜け落ちている現実を目の当たりにしました。もず研究所はその課題に取り組むために設立しました。
島田 舞 Mai Shimada, M.D., M.B.A.
08 — 会社概要
日本の医療AIのための、
データと評価をつくる会社です。
医療AIの成否を決めるのは、モデルでも計算資源でもなく、どの患者を学習したかです。もず研究所はその前提に立ち、2025年10月に設立されました。
- COMPANY
- もず研究所
- STRUCTURE
- Public Benefit Corporation(PBC)公益目的:日本の人々の健康を向上する
- LOCATION
- San Francisco, California, USA
09 — お問い合わせ
お問い合わせはこちらから。
ご質問やご相談など、何でもお気軽にご連絡ください。
- info@mozuhealth.com